XHS-Downloader — 提取小红书作品链接并批量下载图文视频,支持去重与多模式调用 · Shelfry
shelfry.app/p/xhs-downloader 
XHS-Downloader
XHS-Downloader 是一个面向小红书作品采集与下载的开源工具,可解析作品链接,采集标题、作者、媒体地址等信息,并批量下载图文、视频、封面及 livePhoto 文件。它支持单次输入多个链接,自动跳过已下载作品,提供文件完整性处理、断点续传和自定义命名格式。除图形界面与 TUI 外,还能以命令行、API、MCP 服务或油猴脚本方式使用,并能与浏览器脚本联动推送下载任务,适合需要归档小红书内容的用户。
macOSWindowsLinuxMCP Server GPL-3.0 $pip install -r requirements.txt 📸 程序截图
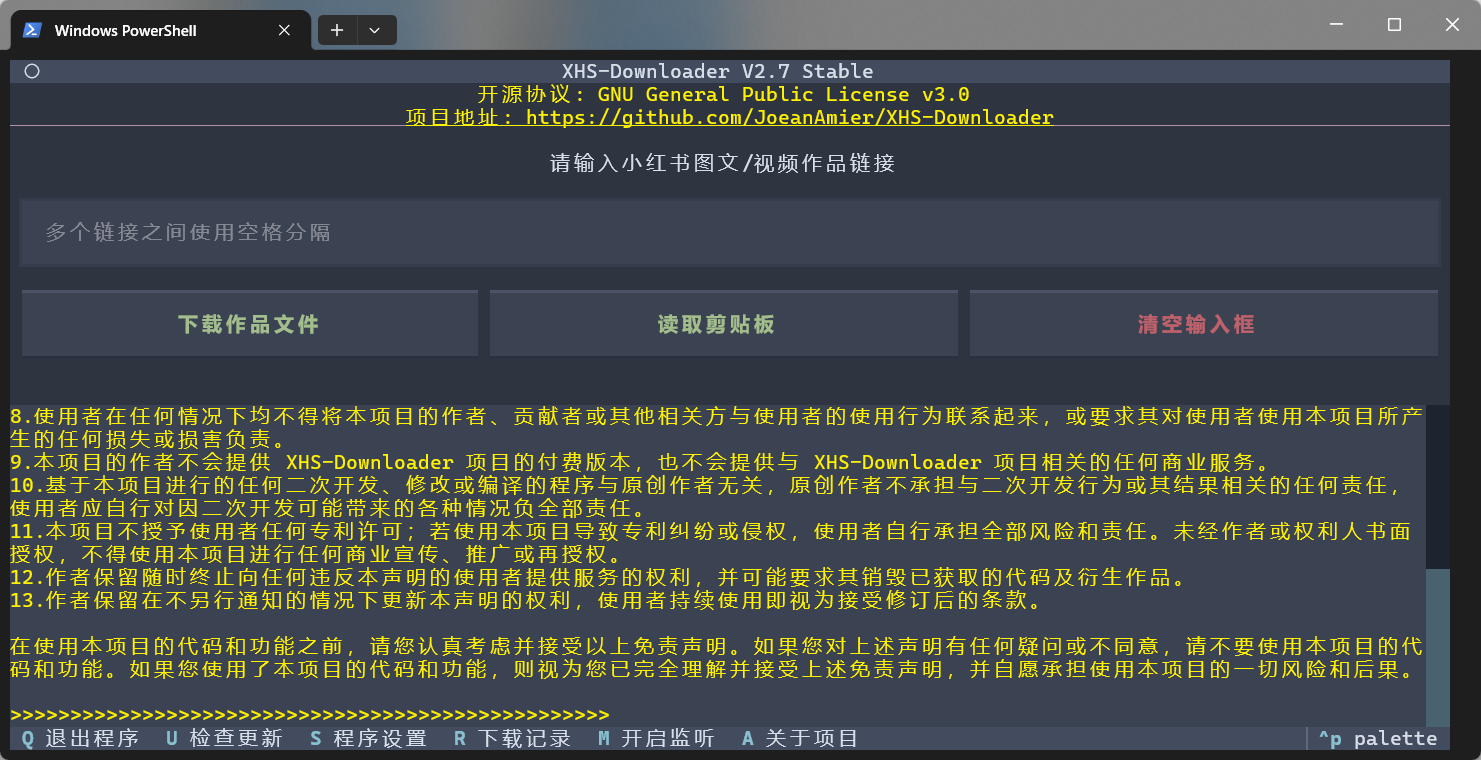
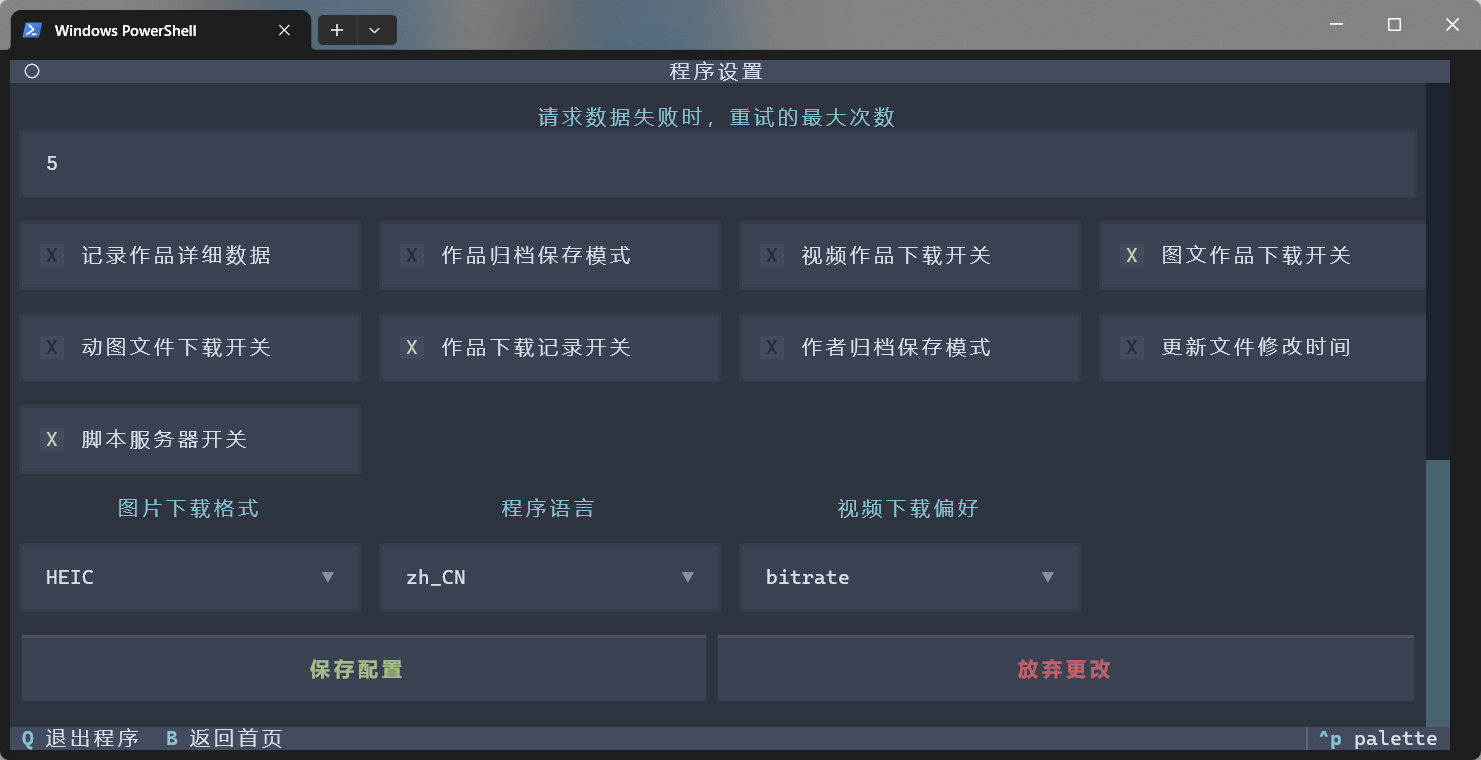
TUI 界面截图(模式命令:python .\main.py TUI)
🔗 支持链接
支持单次输入多个作品链接,链接之间使用空格分隔;程序会自动提取有效链接,无需额外处理!
🥣 使用方法
如果仅需下载作品文件,建议选择 程序运行 或 Docker 运行;如果有其他需求,建议选择 源码运行!
⚠️ Cookie 配置为非强制项;如遇功能异常,建议配置或更新 Cookie 后再次尝试!
⚠️ 未设置 Cookie 时,视频作品只能下载低分辨率文件;建议配置 Cookie 以获取更高画质(无需登录账号)!
🖱 程序运行
⭐ Mac OS、Windows 10 及以上用户可前往 Releases 或者 Actions 下载程序压缩包,解压后打开程序文件夹,双击运行 main 即可使用。
⭐ 本项目包含自动构建可执行文件的 GitHub Actions,使用者可以随时使用 GitHub Actions 将最新源码构建为可执行文件!
⭐ 自动构建可执行文件教程请查阅本文档的 构建可执行文件指南 部分;如果需要更加详细的图文教程,请 查阅文章!
注意:由于 Mac OS 平台的可执行文件 main 未经过代码签名,首次运行时会受到系统安全限制。请先在终端执行 xattr -cr 项目文件夹路径 命令移除安全标记,执行一次后即可正常运行。
若通过此方式使用程序,文件默认下载路径为:.\Volume\Download;配置文件路径为:.\Volume\settings.json
程序更新
方案一:下载并解压文件,将旧版本的 Volume 文件夹复制到新版本的程序根目录。
方案二:下载并解压文件(不要运行程序),复制全部文件,直接覆盖旧版本文件。
⌨️ 源码运行
运行 python -m venv venv 命令创建虚拟环境(可选)
运行 .\venv\Scripts\activate.ps1 或者 venv\Scripts\activate 命令激活虚拟环境(可选)
运行 python .\main.py 或者 python main.py 命令启动 XHS-Downloader
运行 uv sync --no-dev 命令同步环境依赖
运行 uv run main.py 命令启动 XHS-Downloader
⌨️ Docker 运行
方式二:使用 docker pull joeanamier/xhs-downloader 命令拉取镜像
方式三:使用 docker pull ghcr.io/joeanamier/xhs-downloader 命令拉取镜像
TUI 模式:docker run --name 容器名称(可选) -p 主机端口号:5556 -v xhs_downloader_volume:/app/Volume -it <镜像名称>
API 模式:docker run --name 容器名称(可选) -p 主机端口号:5556 -v xhs_downloader_volume:/app/Volume -it <镜像名称> python main.py api
MCP 模式:docker run --name 容器名称(可选) -p 主机端口号:5556 -v xhs_downloader_volume:/app/Volume -it <镜像名称> python main.py mcp
注意:此处的 <镜像名称> 需与您在第一步中使用的镜像名称保持一致(joeanamier/xhs-downloader 或 ghcr.io/joeanamier/xhs-downloader)
启动容器:docker start -i 容器名称/容器 ID
重启容器:docker restart -i 容器名称/容器 ID
Docker 运行项目时不支持 命令行调用模式,无法使用 读取剪贴板 与 监听剪贴板 功能,可以正常粘贴内容,其他功能如有异常请反馈!
🛠 命令行模式
命令行模式说明,适合习惯命令行操作或需要脚本化调用的用户(点击展开)
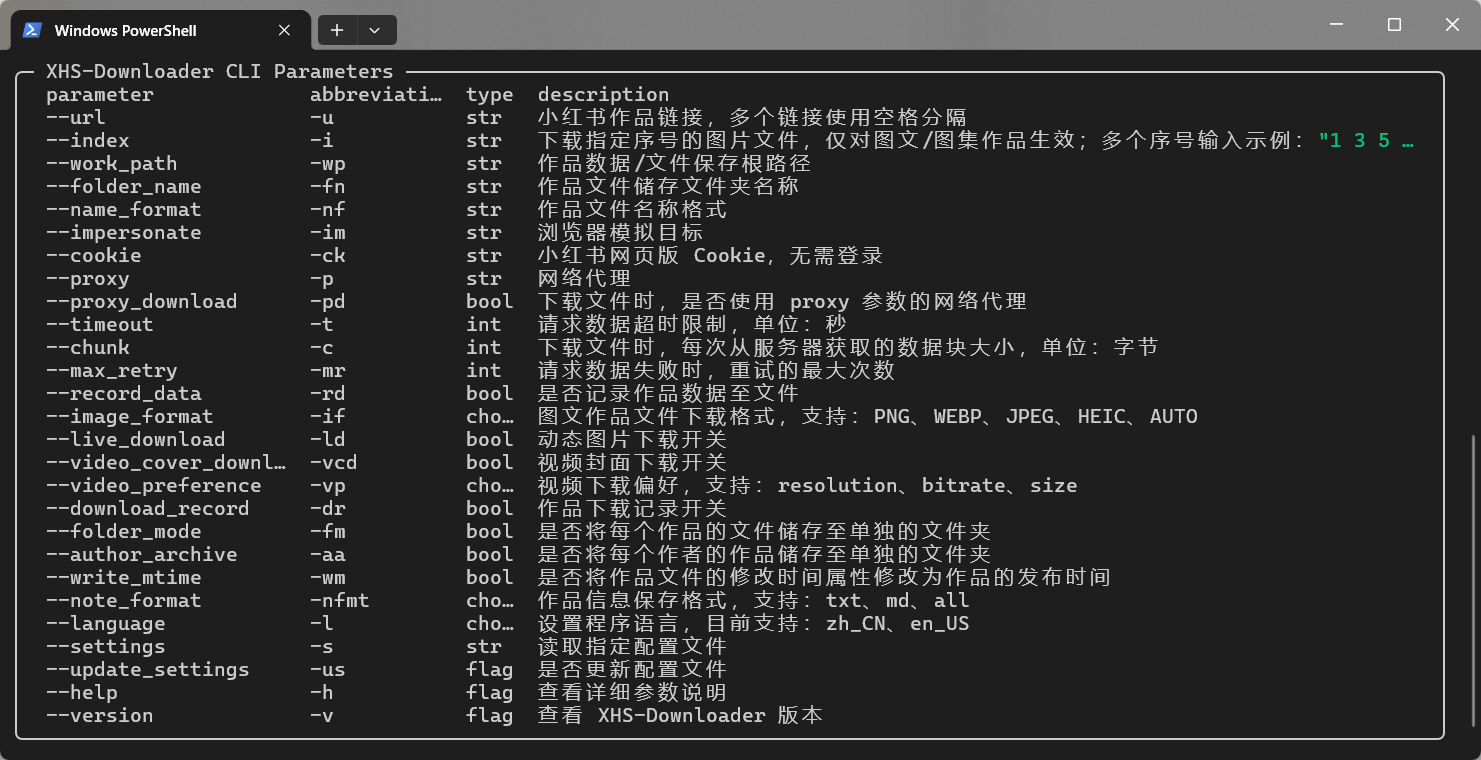
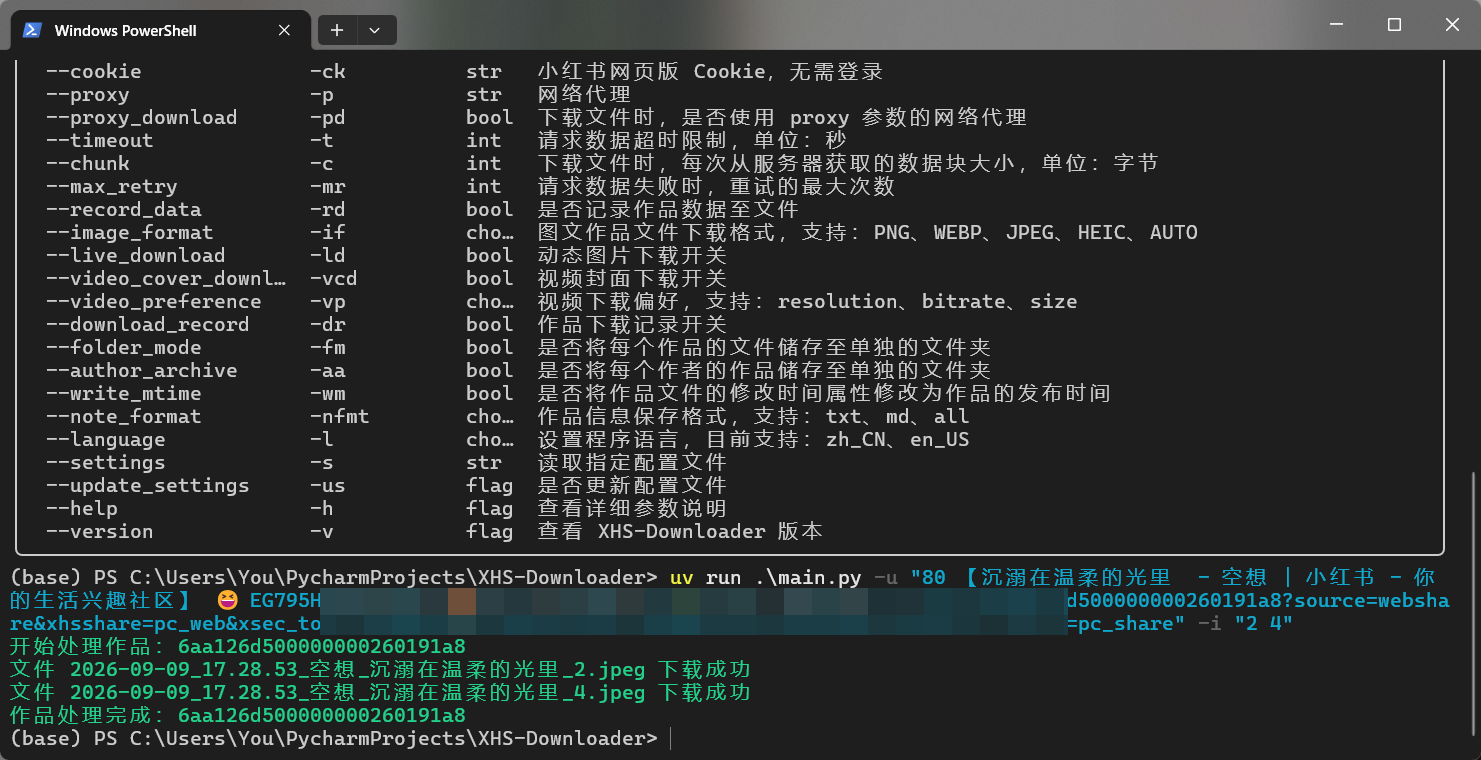
项目支持命令行运行模式,可通过命令行参数直接下载作品文件,也可以设置需要下载的图片序号!
注意:未设置 --index 参数时,支持传入多个作品链接,全部链接需要使用引号包围,链接之间使用空格分隔;已设置 --index 参数时,不支持传入多个作品链接,即使传入多个作品链接,程序仅处理首个作品链接!
bool 类型参数支持使用 true、false、1、0、yes、no、on 或 off(不区分大小写)来设置。
从浏览器读取 Cookie
可以使用命令行实现 从浏览器读取 Cookie 并写入配置文件!
命令示例:python .\main.py --browser_cookie Chrome --update_settings
兼容性提醒:此功能依赖的第三方模块已长期未更新,可能无法正常支持最新浏览器版本。若功能出现异常,请尝试手动获取 Cookie!
🖥 服务器模式
API 模式
API 模式说明,适合需要调用接口获取作品数据或下载文件的开发者(点击展开)
启动:运行命令:python .\main.py api
是否下载作品文件;设置为 true 将会耗费更多时间;可选参数
下载指定序号的图片文件,仅对图文作品生效;download 参数设置为 false 时不生效;可选参数
MCP 模式
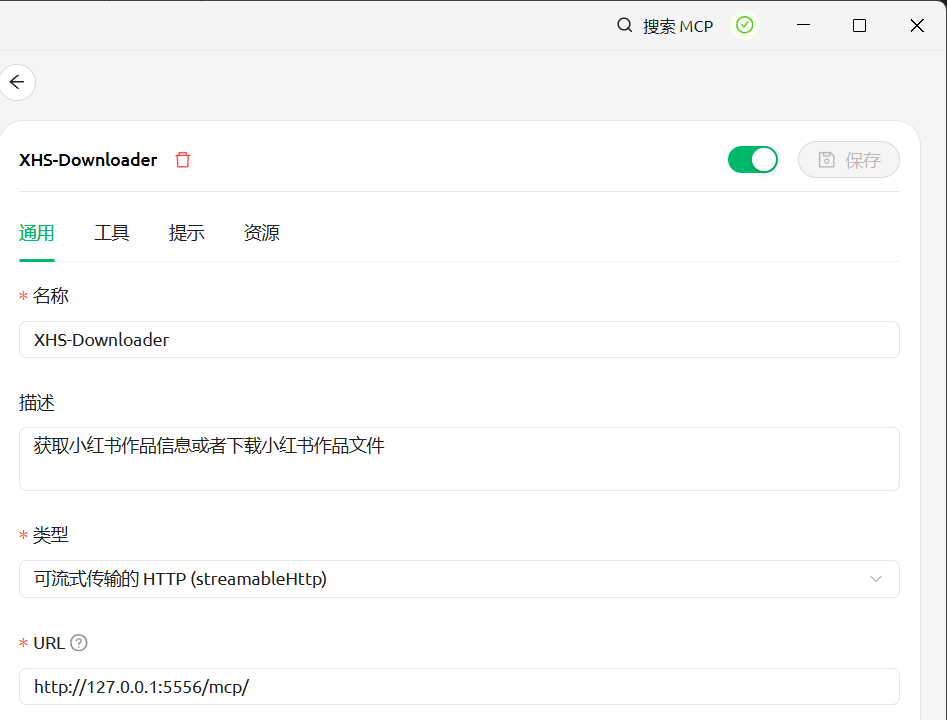
MCP 模式说明,适合需要启动 MCP 服务接入 AI 助手等工具的开发者(点击展开)
启动:运行命令:python .\main.py mcp
MCP 配置示例
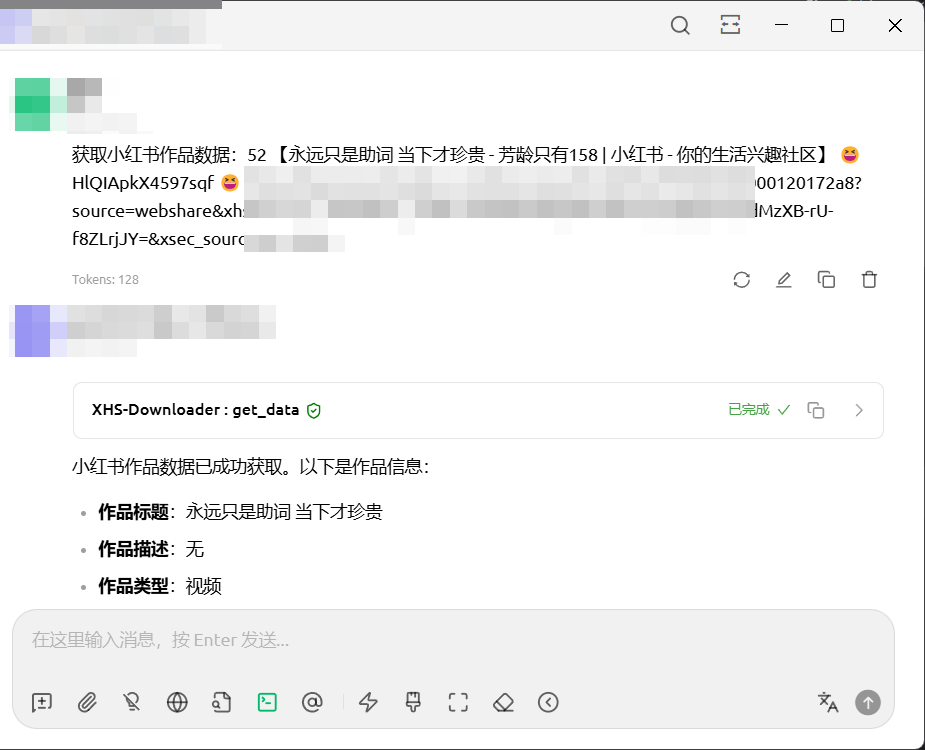
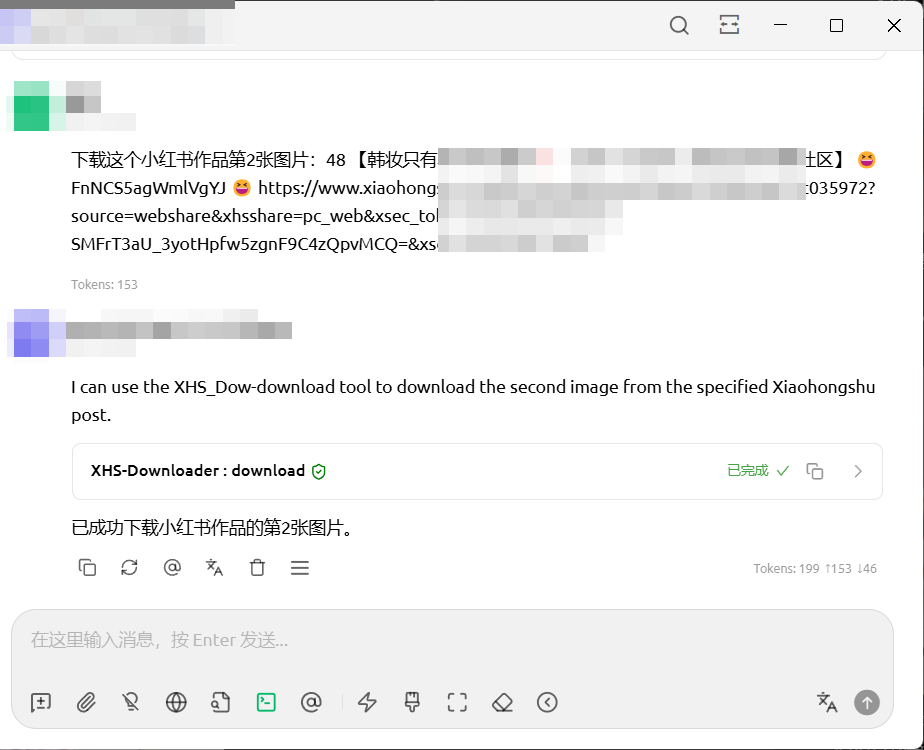
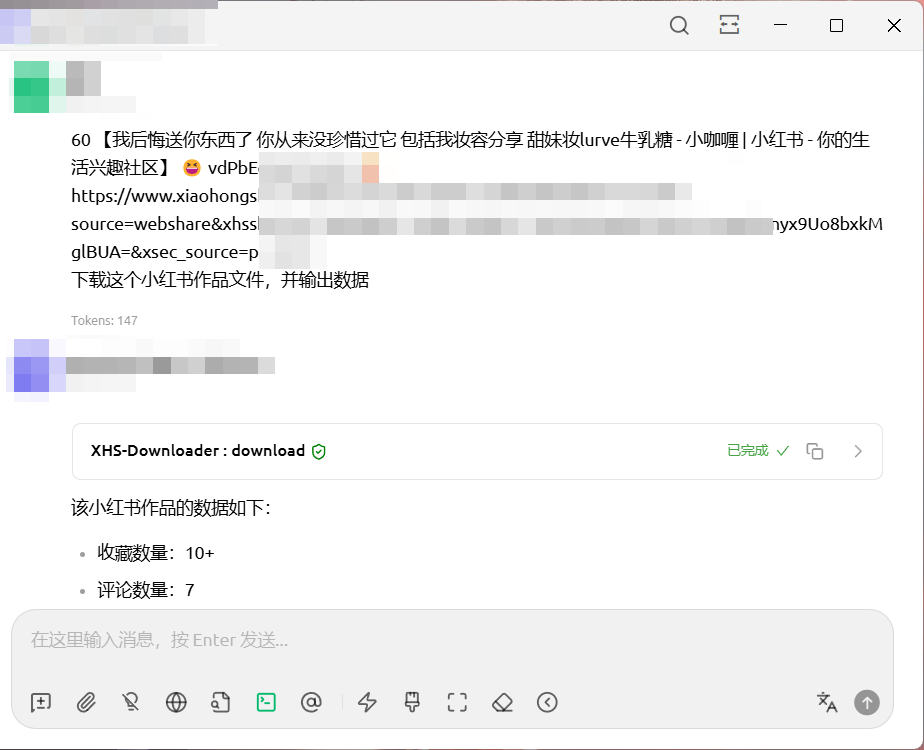
MCP 调用示例
下载图文作品时可以指定需要下载的图片序号;默认不返回作品信息,如需返回作品信息,请在对话时明确表述。
📜 其他说明
由于作品链接携带日期信息,使用先前日期获取的作品链接可能会被风控,建议下载作品文件时使用最新获取的作品链接
如果需要程序使用代理请求数据,请在配置文件 settings.json 设置 proxy 参数
Windows 系统需要以管理员身份运行程序才能读取 Chromium、Chrome、Edge 浏览器 Cookie
如果开启保存作品数据至文件功能,作品数据默认储存至 ./Volume/Download/ExploreData.db 文件
程序下载记录数据储存至 ./Volume/ExploreID.db 文件
为了避免请求频率过高对平台服务器造成影响,本项目内置请求延时机制
🕹 用户脚本
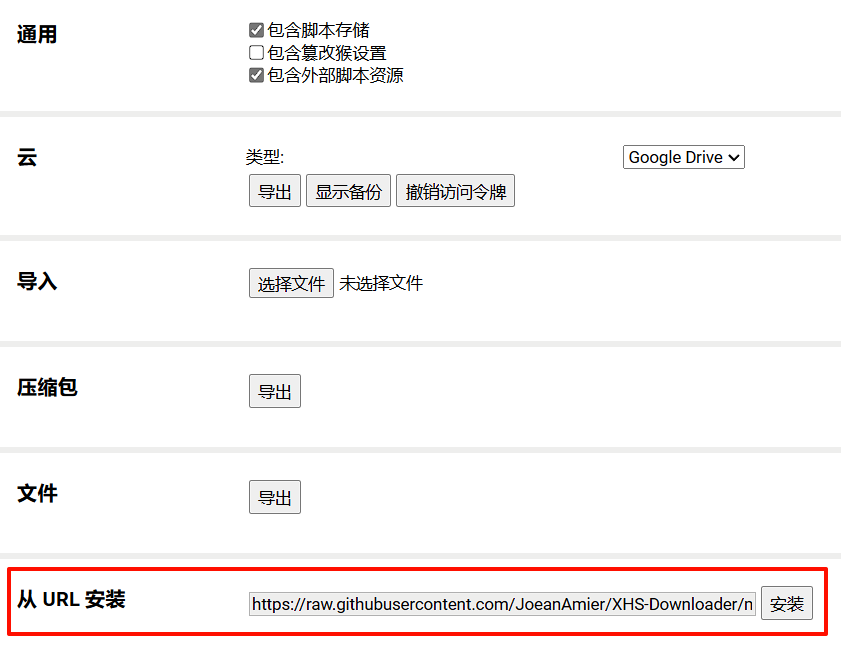
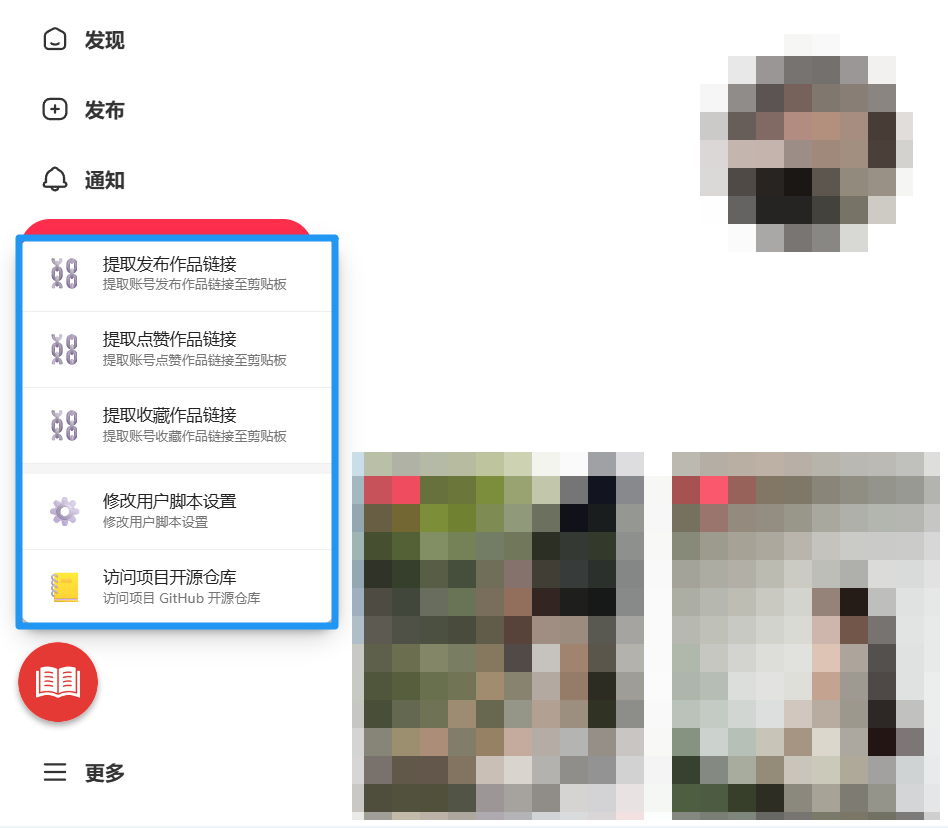
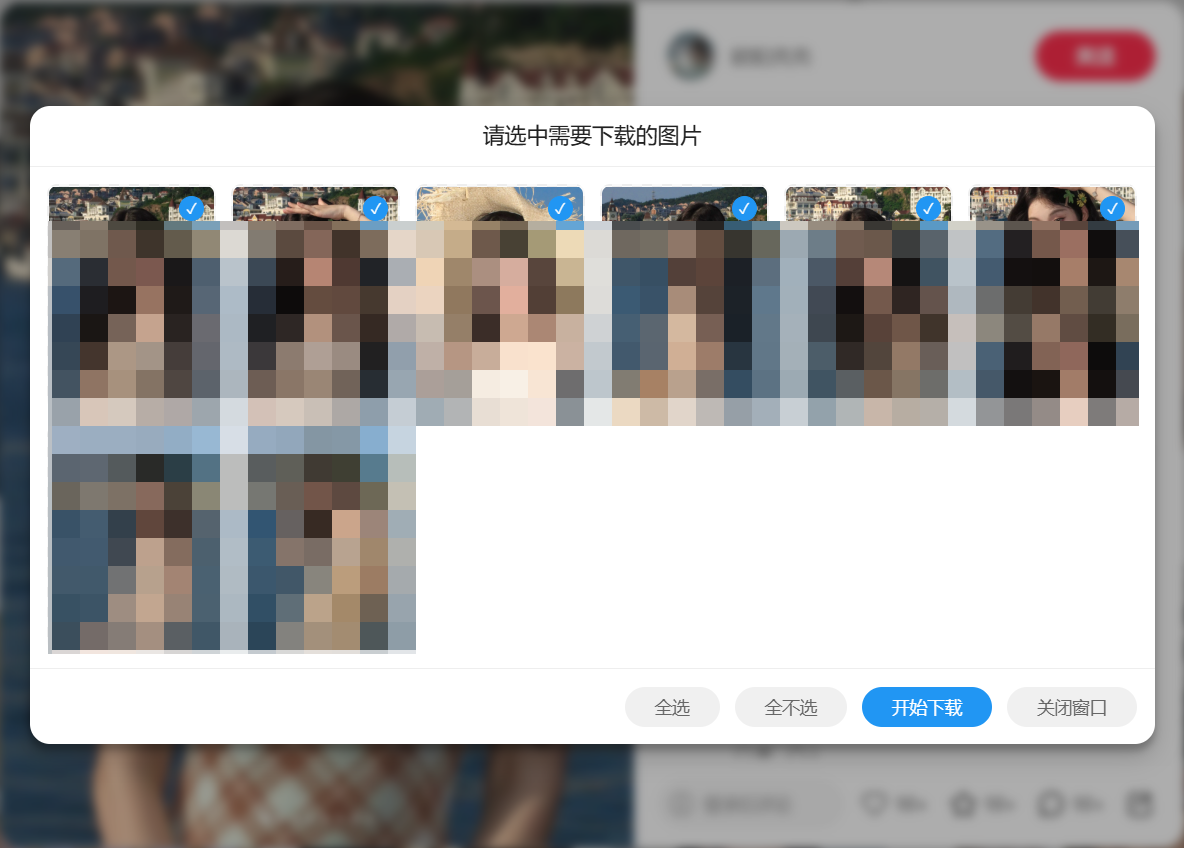
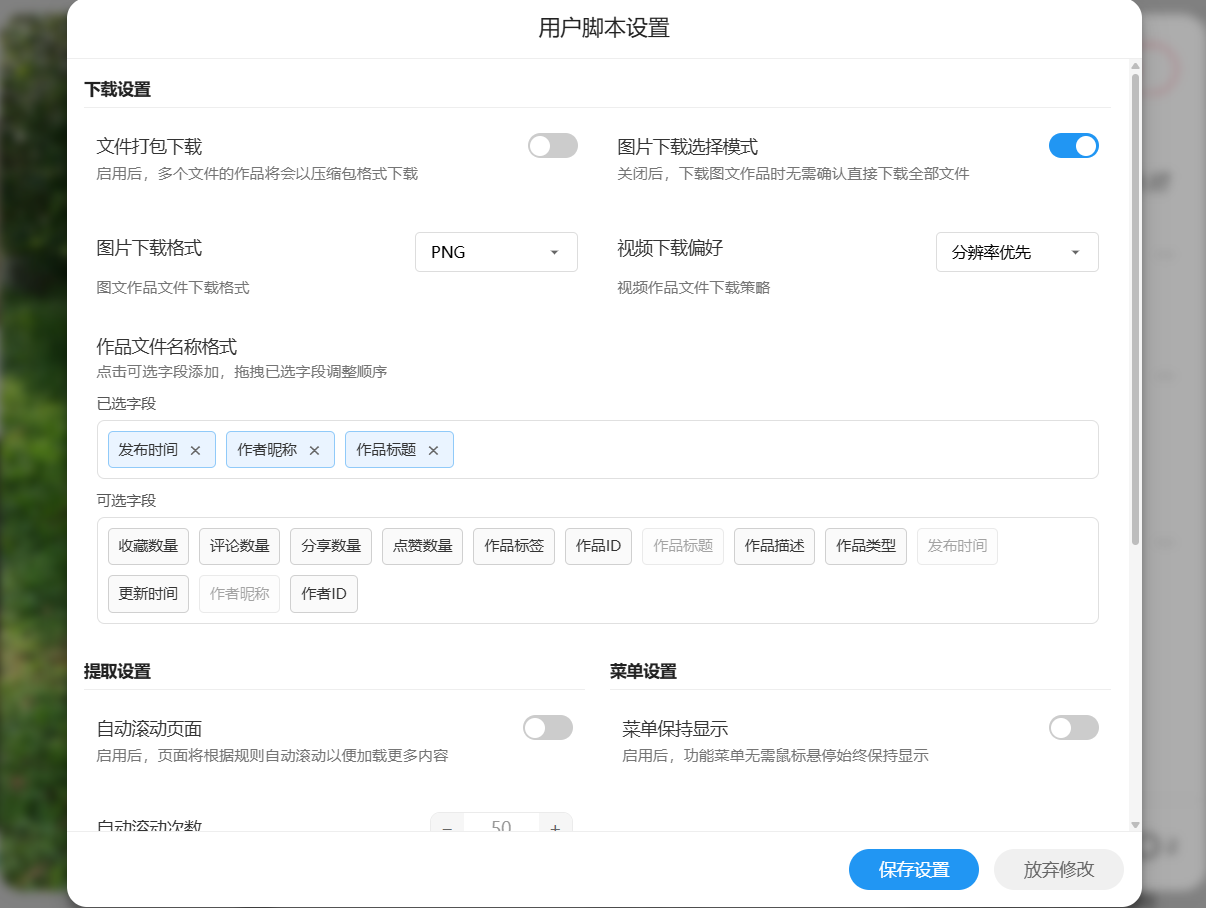
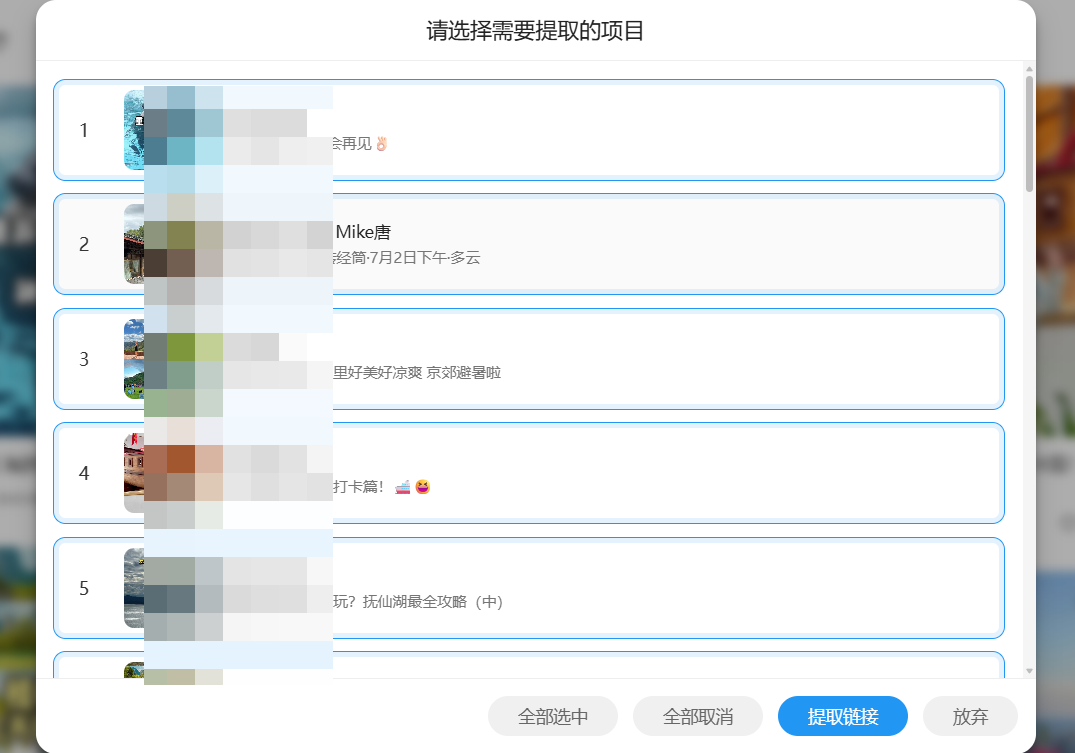
查看 Tampermonkey 用户脚本截图(点击展开)
提示:使用 XHS-Downloader 用户脚本批量提取作品链接,搭配 XHS-Downloader 程序可以实现批量下载作品文件!
🌏 连接服务器
⭐ 本项目支持通过浏览器用户脚本与主程序联动,实现一键推送下载任务。
在项目程序的配置文件中,需要将 script_server 参数设置为 true
保持项目程序在后台运行,它将作为服务器,接收用户脚本的指令(TUI、MCP 和 API 模式均支持)
当您在浏览器中访问作品页面时,点击用户脚本菜单中的 推送下载任务 选项
用户脚本会将下载任务发送给项目程序,由项目程序负责处理和下载文件
📜 脚本说明
下载小红书作品文件时,脚本需要花费时间处理文件,请等待片刻,请勿多次点击下载按钮
提取账号发布、收藏、点赞、专辑作品链接时,脚本可以自动滚动页面直至加载全部作品
提取推荐作品链接、搜索作品、用户链接时,脚本可以自动滚动指定次数加载更多内容,默认滚动次数:50 次
自动滚动页面功能默认关闭;用户可以自由开启,并修改滚动页面次数,修改后立即生效
如果未开启自动滚动页面功能,用户需要手动滚动页面以便加载更多内容后再进行其他操作
支持作品文件打包下载;该功能默认开启,多个文件的作品将会以压缩包格式下载
向服务器推送下载任务时,文件格式、名称规则等设置以服务器配置文件中的设置为准
使用全局代理工具可能会导致脚本下载文件失败,如有异常,请尝试关闭代理工具,必要时向作者反馈
XHS-Downloader 用户脚本仅实现可见即可得的数据采集功能,无任何收费功能和破解功能
自动滚动页面功能代码已重构,该功能默认关闭!启用该功能可能会被小红书检测为自动化操作,从而导致账号受到风控或封禁风险!
💻 二次开发
二次开发代码示例,适合基于项目进行二次开发的开发者(点击展开)
如果有其他需求,可以根据 example.py 的注释提示进行代码调用或修改!
async def example():
"""通过代码设置参数,适合二次开发"""
# 示例链接
demo_link = "https://www.xiaohongshu.com/explore/XXX?xsec_token=XXX"
# 实例对象
work_path = "D:\" # 作品数据/文件保存根路径,默认值:项目根路径
folder_name = "Download" # 作品文件储存文件夹名称(自动创建),默认值:Download
name_format = "作品标题 作品描述"
impersonate = "chrome146" # 浏览器模拟目标
cookie = "" # 小红书网页版 Cookie
proxy = None # 网络代理
proxy_download = False # 下载文件时,是否使用 proxy 参数的网络代理
timeout = 5 # 请求数据超时限制,单位:秒
chunk = 1024 * 1024 * 10 # 下载文件时,每次从服务器获取的数据块大小,单位:字节
max_retry = 2 # 请求数据失败时,重试的最大次数,单位:次
record_data = False # 是否保存作品数据至文件
image_format = "WEBP" # 图文作品文件下载格式,支持:AUTO、PNG、WEBP、JPEG、HEIC
folder_mode = False # 是否将每个作品的文件储存至单独的文件夹
image_download = True # 图文、图集作品文件下载开关
video_download = True # 视频作品文件下载开关
video_cover_download = False # 视频作品封面文件下载开关
live_download = False # 图文动图文件下载开关
download_record = True # 是否记录下载成功的作品 ID
language = "zh_CN" # 设置程序提示语言
author_archive = True # 是否将每个作者的作品存至单独的文件夹
write_mtime = True # 是否将作品文件的 修改时间 修改为作品的发布时间
note_format = "" # 作品信息保存格式,支持:txt、md、all,为空则不保存
# read_cookie = None # 读取浏览器 Cookie,支持设置浏览器名称(字符串)或者浏览器序号(整数),设置为 None 代表不读取
# async with XHS() as xhs:
# pass # 使用默认参数
async with XHS(
work_path=work_path,
folder_name=folder_name,
name_format=name_format,
impersonate=impersonate,
cookie=cookie,
proxy=proxy,
proxy_download=proxy_download,
timeout=timeout,
chunk=chunk,
max_retry=max_retry,
record_data=record_data,
image_format=image_format,
folder_mode=folder_mode,
image_download=image_download,
video_download=video_download,
video_cover_download=video_cover_download,
live_download=live_download,
download_record=download_record,
language=language,
# read_cookie=read_cookie,
author_archive=author_archive,
write_mtime=write_mtime,
note_format=note_format,
) as xhs: # 使用自定义参数
download = True # 是否下载作品文件,默认值:False
# 返回作品详细信息,包括下载地址
# 获取数据失败时返回空字典
print(
await xhs.extract(
demo_link,
download,
index=[
1,
2,
5,
],
)
)
📋 读取剪贴板
读取剪贴板平台说明,适合 Windows 以外的用户(Mac / Linux)(点击展开)
项目使用 pyperclip 实现读取剪贴板功能,该模块在不同的系统上会有差异。
在 Mac 上,该模块使用 pbcopy 和 pbpaste 命令,这些命令应该随操作系统一起提供。
在 Linux 上,该模块使用 xclip 或 xsel 命令,这些命令应该随操作系统一起提供。否则,请运行 "sudo apt-get install xclip" 或 "sudo apt-get install xsel"(注意:xsel 似乎并不总是有效)
在其他 Linux 系统上,你需要安装 qtpy 或 PyQT5 模块。
⚙️ 配置文件
配置文件参数说明,适合需要直接修改程序配置参数的用户(点击展开)
项目根目录下的 ./Volume/settings.json 文件,首次运行自动生成,可以自定义程序运行参数;如果设置了无效的参数值,程序将会使用参数默认值!
如果您在程序界面修改配置时无法正常交互,可以直接编辑配置文件;如果您的计算机没有合适的程序编辑 JSON 文件,建议使用 在线工具 编辑配置文件内容,修改后需要重启软件才能生效。
作品文件名称格式,字段之间使用空格分隔,支持字段:收藏数量、评论数量、分享数量、点赞数量、作品标签、作品ID、作品标题、作品描述、作品类型、发布时间、最后更新时间、作者昵称、作者ID
小红书网页版 Cookie,无需登录,非必需参数!
下载文件时,每次从服务器获取的数据块大小,单位:字节
是否保存作品数据至 SQLite 数据库(所有作品统一保存)
图文作品文件下载格式,支持:AUTO、PNG、WEBP、JPEG、HEIC
部分作品没有 HEIC 格式的文件,此时下载的文件可能为 WEBP 格式!
设置为 AUTO 时表示动态格式,实际格式取决于服务器响应数据!
视频作品封面下载开关;封面格式与图文作品文件格式一致
视频作品文件下载偏好;含义:resolution:分辨率优先;bitrate:码率优先;size:文件大小优先
是否将每个作品的文件储存至单独的文件夹;文件夹名称与文件名称保持一致
是否记录下载成功的作品 ID,如果开启,程序将会自动跳过下载存在记录的作品
#
是否将每个作者的作品储存至单独的文件夹;文件夹名称为 作者ID_作者昵称
是否将作品文件的 修改时间 属性修改为作品的发布时间
是否开启用户脚本服务器,用于接收浏览器用户脚本的下载任务(TUI、MCP 和 API 模式生效)
作品信息保存格式(每个作品单独保存);含义:txt:纯文本;md:Markdown;all:全部格式;为空则不保存
如果 author_archive 参数设置为 true,程序会把每个作者的作品储存至单独的文件夹;当作者的昵称发生变化时,程序会自动更新已下载作品文件名称中的作者昵称部分!
除此之外,你还可以通过设置 mapping_data 参数为某个作者设置别名;如果对某个作者设置了别名,程序会使用你设置的作者别名去替代作者昵称!
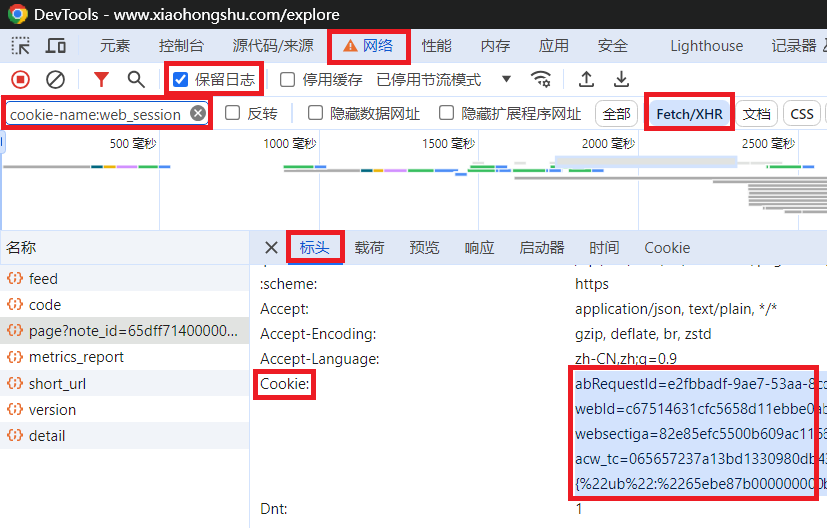
🌐 Cookie
在 过滤 输入框输入 cookie-name:web_session
在 网络 选项卡选择任意数据包(如果无数据包,重复步骤7)
🗳 下载记录
XHS-Downloader 会将下载过的作品 ID 储存至数据库,当重复下载相同的作品时,XHS-Downloader 会自动跳过该作品的文件下载(即使作品文件不存在),如果想要重新下载作品文件,请先删除数据库中对应的作品 ID,再使用 XHS-Downloader 下载作品文件!
该功能默认开启,如果关闭该功能,XHS-Downloader 会检查文件是否存在,若文件存在则跳过下载!
构建可执行文件指南
构建可执行文件指南,适合希望自行构建可执行文件的用户(点击展开)
本指南将引导您通过 Fork 本仓库并执行 GitHub Actions 自动完成基于最新源码的程序构建和打包!
使用步骤
1. Fork 本仓库
- 点击项目仓库右上角的 Fork 按钮,将本仓库 Fork 到您的个人 GitHub 账户中
- 您的 Fork 仓库地址将类似于:
https://github.com/your-username/this-repo
2. 启用 GitHub Actions
- 前往您 Fork 的仓库页面
- 点击顶部的 Settings 选项卡
- 点击右侧的 Actions 选项卡
- 点击 General 选项
- 在 Actions permissions 下,选择 Allow all actions and reusable workflows 选项,点击 Save 按钮
3. 手动触发打包流程
- 在您 Fork 的仓库中,点击顶部的 Actions 选项卡
- 找到名为 构建可执行文件 的工作流
- 点击右侧的 Run workflow 按钮:
- 选择 master 或者 develop 分支
- 点击 Run workflow
4. 查看打包进度
- 在 Actions 页面中,您可以看到触发的工作流运行记录
- 点击运行记录,查看详细的日志以了解打包进度和状态
5. 下载打包结果
- 打包完成后,进入对应的运行记录页面
- 在页面底部的 Artifacts 部分,您将看到打包的结果文件
- 点击下载并保存到本地,即可获得打包好的程序
注意事项
-
资源使用:
- Actions 的运行环境由 GitHub 免费提供,普通用户每月有一定的免费使用额度(2000 分钟)
-
代码修改:
- 您可以自由修改 Fork 仓库中的代码以定制程序打包流程
- 修改后重新触发打包流程,您将得到自定义的构建版本
-
与主仓库保持同步:
- 如果主仓库更新了代码或工作流,建议您定期同步 Fork 仓库以获取最新功能和修复
Actions 常见问题
Q1: 为什么我无法触发工作流?
A: 请确认您已按照步骤 启用 Actions,否则 GitHub 会禁止运行工作流
Q2: 打包流程失败怎么办?
- 检查运行日志,了解失败原因
- 确保代码没有语法错误或依赖问题
- 如果问题仍未解决,可以在本仓库的 Issues 页面 提出问题
Q3: 我可以直接使用主仓库的 Actions 吗?
A: 由于权限限制,您无法直接触发主仓库的 Actions。请通过 Fork 仓库的方式执行打包流程
💝 项目赞助
DartNode
♥️ 支持项目
如果 XHS-Downloader 对您有帮助,请考虑为它点个 Star ⭐,感谢您的支持!
如果您愿意,可以考虑提供资助为 XHS-Downloader 提供额外的支持!
🌟 贡献指南
贡献指南,适合希望为本项目贡献代码的开发者(点击展开)
欢迎对本项目做出贡献!为了保持代码库的整洁、高效和易于维护,请仔细阅读以下指南,以确保您的贡献能够顺利被接受和整合。
在开始开发前,请从 develop 分支拉取最新的代码,以此为基础进行修改;这有助于避免合并冲突并保证您的改动基于最新的项目状态。
如果您的更改涉及多个不相关的功能或问题,请将它们分成多个独立的提交或拉取请求。
每个拉取请求应尽可能专注于单一功能或修复,以便于代码审查和测试。
遵循现有的代码风格;请确保您的代码与项目中已有的代码风格保持一致;建议使用 Ruff 工具保持代码格式规范。
编写可读性强的代码;添加适当的注释帮助他人理解您的意图。
每个提交都应该包含一个清晰、简洁的提交信息,以描述所做的更改。提交信息应遵循以下格式:<类型>: <简短描述>
当您准备提交拉取请求时,请优先将它们提交到 develop 分支;这是为了给维护者一个缓冲区,在最终合并到 master
分支之前进行额外的测试和审查。
建议在开发前或遇到疑问时与作者沟通,确保开发方向一致,避免重复劳动或无效提交。
✉️ 联系作者
说明:QQ 群聊仅限于讨论项目使用问题,严禁发布任何广告,严禁讨论任何账号交易、账号流量、流量变现、灰色产业等相关的内容!
⭐ Star 趋势
⚠️ 免责声明
使用者对本项目的使用由使用者自行决定,并自行承担风险。作者对使用者使用本项目所产生的任何损失、责任、或风险概不负责。
本项目的作者提供的代码和功能是基于现有知识和技术的开发成果。作者按现有技术水平努力确保代码的正确性和安全性,但不保证代码完全没有错误或缺陷。
本项目依赖的所有第三方库、插件或服务各自遵循其原始开源或商业许可,使用者需自行查阅并遵守相应协议,作者不对第三方组件的稳定性、安全性及合规性承担任何责任。
使用者在使用本项目的代码和功能时,必须自行研究相关法律法规,并确保其使用行为合法合规。任何因违反法律法规而导致的法律责任和风险,均由使用者自行承担。
使用者不得使用本工具从事任何侵犯知识产权的行为,包括但不限于未经授权下载、传播受版权保护的内容,开发者不参与、不支持、不认可任何非法内容的获取或分发。
本项目不对使用者涉及的数据收集、存储、传输等处理活动的合规性承担责任。使用者应自行遵守相关法律法规,确保处理行为合法正当;因违规操作导致的法律责任由使用者自行承担。
使用者在任何情况下均不得将本项目的作者、贡献者或其他相关方与使用者的使用行为联系起来,或要求其对使用者使用本项目所产生的任何损失或损害负责。
本项目的作者不会提供 XHS-Downloader 项目的付费版本,也不会提供与 XHS-Downloader 项目相关的任何商业服务。
基于本项目进行的任何二次开发、修改或编译的程序与原创作者无关,原创作者不承担与二次开发行为或其结果相关的任何责任,使用者应自行对因二次开发可能带来的各种情况负全部责任。
本项目不授予使用者任何专利许可;若使用本项目导致专利纠纷或侵权,使用者自行承担全部风险和责任。未经作者或权利人书面授权,不得使用本项目进行任何商业宣传、推广或再授权。
作者保留随时终止向任何违反本声明的使用者提供服务的权利,并可能要求其销毁已获取的代码及衍生作品。
作者保留在不另行通知的情况下更新本声明的权利,使用者持续使用即视为接受修订后的条款。
在使用本项目的代码和功能之前,请您认真考虑并接受以上免责声明。如果您对上述声明有任何疑问或不同意,请不要使用本项目的代码和功能。如果您使用了本项目的代码和功能,则视为您已完全理解并接受上述免责声明,并自愿承担使用本项目的一切风险和后果。
💡 项目参考
核心功能
- 采集作品信息并提取媒体下载地址
- 批量下载图文、视频、封面和 livePhoto
- 自动跳过已下载作品并记录作品 ID
- 支持断点续传与文件完整性处理
- 提供命令行、API、MCP 与油猴脚本
- 可自定义文件命名和图文下载格式
内容由编辑整理,部分信息来自 GitHub 与项目官网,版权归原作者所有。发现错误?报告问题